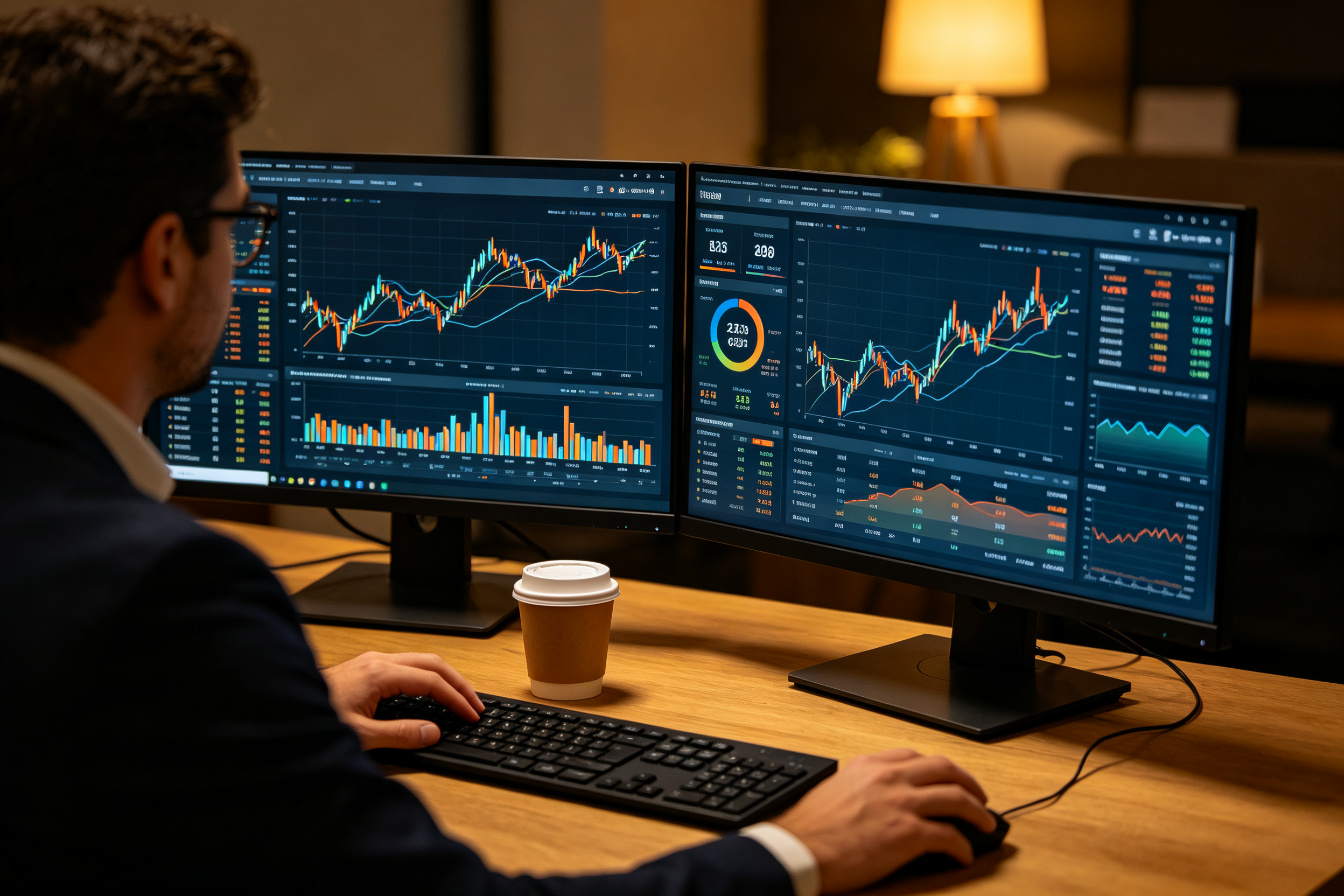
指标:系统状态与性能的量化(CPU、QPS、延迟);日志:事件的详细记录;链路:一次请求的完整调用路径。三者结合,才能既知道“出了事”,又知道“哪里出事”。
有了这三支柱,再配上告警规则与告警触达,就构成完整的监控体系。
原则:先有基础监控(可用性/性能),再逐步精细化;告警要避免“狼来了”,规则要收敛有效。
一套监控系统的组成。
Prometheus/云监控采集。
Grafana 看板展示。
集中采集与检索。
请求全链路定位。
多渠道告警通知。
服务存活与探活。
从基础到完善。
监控服务器资源、服务可用性与核心性能指标。
集中采集日志,支持检索与错误追踪。
设定关键指标告警规则,多渠道触达,避免漏报。
加链路追踪与业务指标,形成完整可观测体系。
优先监控的关键指标。
| 层级 | 指标 |
|---|---|
| 资源 | CPU、内存、磁盘、带宽 |
| 应用 | QPS、延迟、错误率 |
| 数据库 | 连接、慢查询、主从延迟 |
| 业务 | 转化、成功率、关键事件 |
收敛规则:合并同类告警、设置合理阈值、分级告警(严重/警告),避免“狼来了”。
云平台自带监控起步最快;自建用 Prometheus + Grafana;日志用 ELK/Loki。按规模与能力选择。
统一格式与 requestId 关联,支持按时间/关键词/链路检索,快速定位错误现场。
建立应急预案与操作手册,告警附处理指引,配合演练提升处置速度。